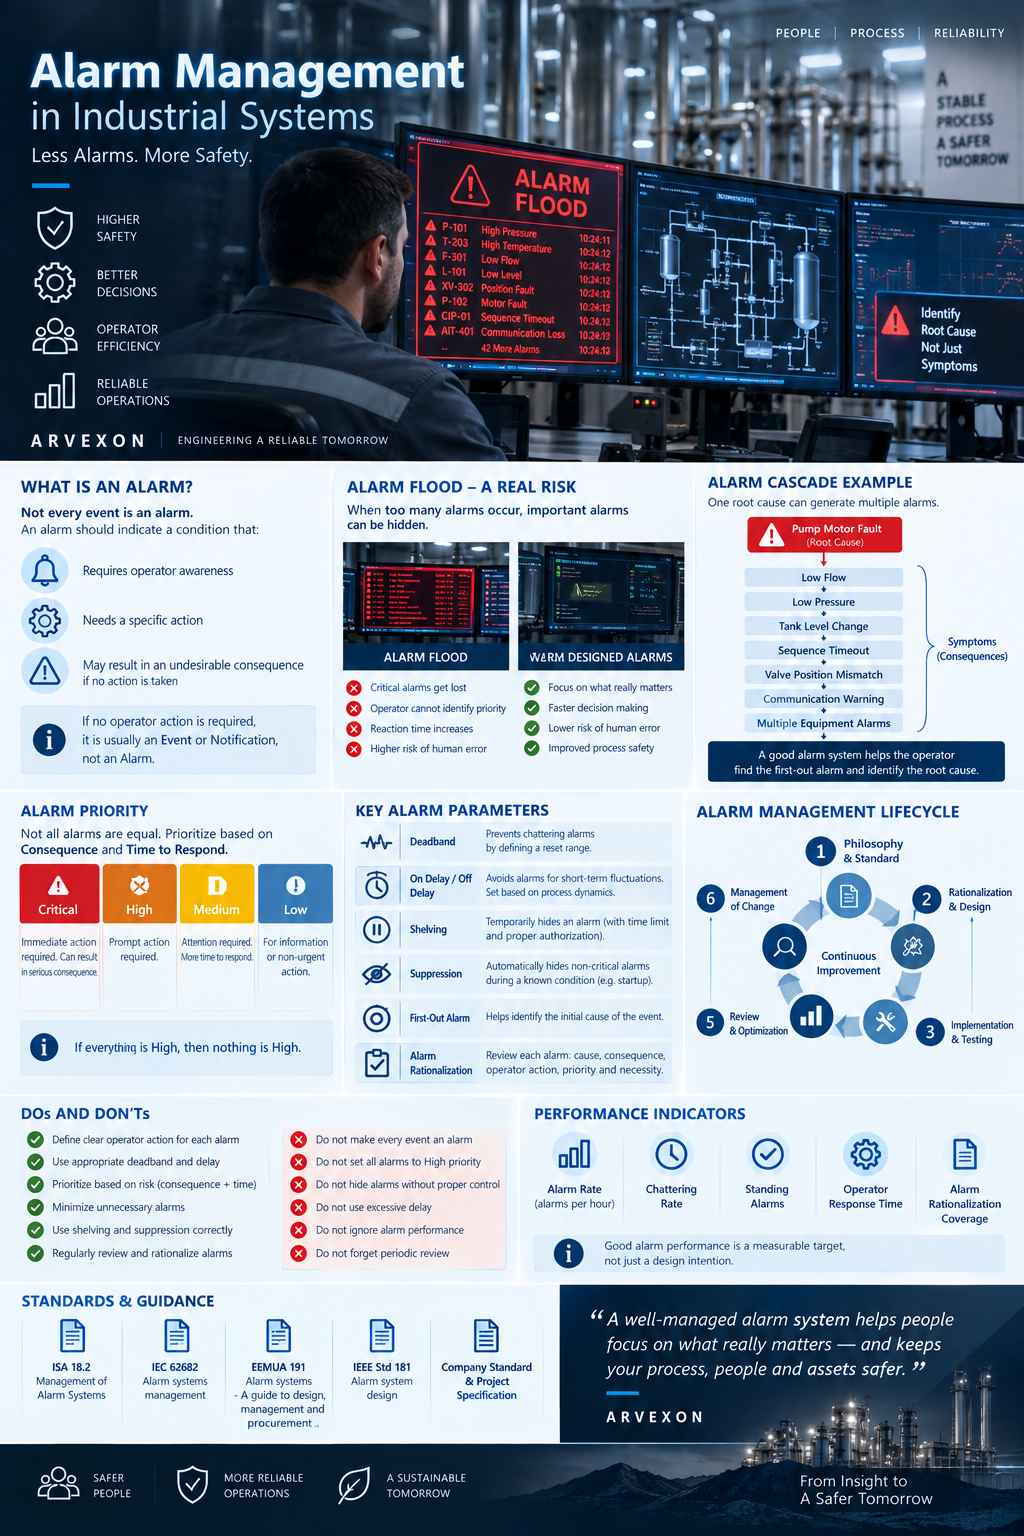
Alarm Management در سیستمهای صنعتی؛ چرا Alarm بیشتر به معنی ایمنی بیشتر نیست؟
در بسیاری از سیستمهای اتوماسیون صنعتی، هر وضعیت غیرعادی بهسادگی به یک Alarm تبدیل میشود.
Pressure بالا است؟ Alarm.
Temperature پایین است؟ Alarm.
Level تغییر کرده؟ Alarm.
Communication یک تجهیز قطع شده؟ Alarm.
در ظاهر، هرچه تعداد Alarmها بیشتر باشد، به نظر میرسد سیستم اطلاعات بیشتری در اختیار Operator قرار میدهد. اما در عمل، یک سیستم با Alarmهای زیاد و بدون منطق مناسب میتواند Operator را دقیقاً در لحظهای که بیشترین نیاز به اطلاعات دارد، با حجم زیادی از پیامهای کماهمیت مواجه کند.اصل مهم این است:وقتی همه چیز Alarm باشد، ممکن است هیچ چیز واقعاً مهم به نظر نرسد.این همان نقطهای است که Alarm Management اهمیت پیدا میکند.
Alarm دقیقاً چیست؟
هر Event، Status یا Condition غیرعادی الزاماً Alarm نیست.یک Alarm باید نشاندهنده وضعیتی باشد که:
- نیازمند آگاهی Operator است.
- Operator باید در پاسخ به آن Action مشخصی انجام دهد.
- در صورت عدم اقدام، احتمال ایجاد یک Consequence نامطلوب وجود دارد.
بنابراین:
Alarm without required operator response is often an Event, Status or Notification — not a true Alarm.
برای مثال:
روشن بودن Pump روی HMI یک Status است.تغییر Position یک Valve که در Historian ثبت میشود یک Event است.اما Low Flow در شرایطی که Operator باید برای جلوگیری از Process Failure اقدام کند، میتواند یک Alarm واقعی باشد.
Alarm Flood؛ وقتی اطلاعات بیش از حد خطرناک میشود
یکی از شرایط جدی در Control Room، Alarm Flood است.Alarm Flood زمانی رخ میدهد که Operator در یک بازه کوتاه با تعداد زیادی Alarm روبهرو شود.در چنین شرایطی:
- Alarmهای مهم ممکن است میان Alarmهای کماهمیت گم شوند.
- تشخیص Priority واقعی دشوار میشود.
- زمان واکنش افزایش پیدا میکند.
- احتمال Human Error افزایش مییابد.
مشکل اینجاست که در یک Major Failure، سیستم دقیقاً زمانی که Operator بیشترین نیاز را به اطلاعات واضح و قابل اقدام دارد، ممکن است بیشترین تعداد Alarm را ایجاد کند.
بنابراین هدف Alarm System نباید صرفاً «گزارش همه چیز» باشد.هدف باید این باشد: Present the right information, at the right time, to the right operator.
Alarm Cascade؛ یک Failure، چندین Alarm
فرض کنید در یک CIP System، Pump به دلیل Motor Fault متوقف میشود.پس از آن ممکن است مجموعهای از Alarmها ظاهر شوند:
Pump Motor Fault
↓
Low Flow
↓
Low Pressure
↓
Tank Level Change
↓
Sequence Timeout
↓
Valve Position Mismatch
↓
Additional Equipment Alarms
در این حالت، تعداد زیادی از Alarmهای ظاهرشده Consequence یک Failure اولیه هستند.علت اصلی ممکن است فقط این باشد:Pump Motor Faultبه همین دلیل یکی از مفاهیم مهم در Alarm Design، کمک به Operator برای تشخیص:First-Out ConditionوRoot Causeاست.یک Alarm System مناسب باید تا حد امکان پاسخ این سؤال را روشن کند:چه چیزی ابتدا خراب شد؟نه اینکه فقط فهرستی از تجهیزاتی که اکنون در وضعیت Fault هستند نمایش دهد.
Priority؛ همه Alarmها برابر نیستند
Alarm Priority باید بر اساس Risk و نیاز واقعی Operator تعیین شود.یکی از رویکردهای رایج، در نظر گرفتن دو عامل است:Consequence + Time to Respond
یعنی اگر Operator اقدام نکند:چه اتفاقی میافتد؟و:چقدر زمان برای واکنش وجود دارد؟بر اساس Alarm Philosophy پروژه ممکن است Priorityهایی مانند:High – Medium – Low
یا طبقهبندیهای دیگری تعریف شوند.برخی سایتها ممکن است Categoryهایی مانند Critical نیز داشته باشند، اما این موضوع باید در Alarm Philosophy همان پروژه تعریف شود؛ نه اینکه بهصورت عمومی برای همه سیستمها فرض شود.اصل مهم این است:اگر تقریباً همه Alarmها High باشند، Priority عملاً معنی خود را از دست میدهد.Priority نباید بر اساس احساس Designer تعیین شود؛ بلکه باید نتیجه یک Rationalization منطقی باشد.
Alarm Rationalization؛ قبل از Configuration فکر کنیم
یکی از مهمترین مراحل Alarm Management، Alarm Rationalization است.در این فرآیند، هر Alarm Candidate باید بهصورت ساختاریافته بررسی شود.برای هر Alarm باید مشخص باشد:
Cause چیست؟
Consequence چیست؟
Operator Action چیست؟
چقدر Time to Respond وجود دارد؟
Priority چیست؟
آیا این Condition واقعاً Alarm است؟
اگر هیچ Action مشخص و مفیدی از Operator انتظار نمیرود، باید بررسی شود که آیا آن مورد بهتر است بهعنوان:Event / Notification / Statusپیادهسازی شود.Alarm Rationalization یکی از مهمترین ابزارها برای جلوگیری از ساخت Alarm Systemهای شلوغ و غیرقابل مدیریت است.
Deadband؛ جلوگیری از Chattering Alarm
فرض کنید Pressure Process دقیقاً نزدیک Alarm Setpoint نوسان میکند.در این شرایط ممکن است Alarm مرتباً:ON → OFF → ON → OFFشود.این وضعیت Chattering Alarm نامیده میشود.یکی از روشهای کنترل آن استفاده از Deadband است.Deadband محدودهای ایجاد میکند که Process Variable باید از آن عبور کند تا Alarm به وضعیت Normal بازگردد.این موضوع خصوصاً در Signalهایی که دارای Noise یا Process Fluctuation هستند اهمیت زیادی دارد.اما مقدار Deadband باید بر اساس Process Behaviour و Instrument Accuracy انتخاب شود؛ Deadband نباید صرفاً برای مخفیکردن یک Signal ناپایدار استفاده شود.
Delay؛ هر Excursion کوتاه یک Alarm نیست
در برخی فرآیندها، یک Condition ممکن است برای مدت کوتاهی بهصورت طبیعی رخ دهد.برای مثال، هنگام تغییر Step یک Sequence ممکن است Pressure برای چند ثانیه کاهش پیدا کند.در این حالت:Low Pressure for 2 seconds ممکن است بخشی طبیعی از Process Transition باشد.اما:Low Pressure sustained for 30 secondsممکن است نشاندهنده Failure باشد.در چنین شرایطی میتوان از:On-Delayو در صورت نیاز:Off-Delayاستفاده کرد.اما Delay باید بر اساس Process Dynamics و Time to Respond تعیین شود.استفاده بیش از حد از Delay برای کاهش تعداد Alarmها میتواند Failure واقعی را دیرتر به Operator اعلام کند.
Shelving؛ کنار گذاشتن موقت یک Alarm
Shelving زمانی استفاده میشود که یک Alarm برای مدت محدود و تحت شرایط کنترلشده از Presentation عادی Operator کنار گذاشته شود.برای مثال، هنگام Maintenance ممکن است Alarm مرتبط با تجهیز در حال تعمیر برای مدت مشخص Shelve شود.Shelving باید:
Authorized
Time-Limited
Visible
Traceable
باشد.Alarm نباید بدون Control بهصورت دائمی توسط Operator غیرفعال شود.در غیر این صورت، Shelving از یک ابزار مدیریت Alarm به روشی برای پنهانکردن مشکلات تبدیل میشود.
Alarm Suppression؛ Alarm فقط زمانی فعال باشد که معنی دارد
Suppression با Shelving یک مفهوم یکسان نیست.در State-Based Suppression، Alarm بر اساس وضعیت Process یا Equipment بهصورت منطقی فعال یا غیرفعال میشود.
برای مثال:Pump Running → Low Flow Alarm Enabledاما:Pump Stopped → Low Flow Alarm Suppressedوقتی Pump خاموش است، Low Flow یک وضعیت کاملاً طبیعی است و نباید Alarm تولید کند.همین منطق میتواند برای:
Startup
Shutdown
Cleaning Mode
Maintenance Mode
Production Mode
استفاده شود.Context-Aware یا State-Based Alarming میتواند تعداد Nuisance Alarmها را بهشدت کاهش دهد، مشروط بر اینکه Suppression Logic بهدرستی طراحی، مستند و تست شود.
Alarm، Interlock و Trip یکی نیستند
این سه مفهوم باید از یکدیگر تفکیک شوند.
Alarm
Operator را از یک Condition مطلع میکند و معمولاً نیازمند Action انسانی است.Interlockاجازه انجام یا ادامه یک Action را بر اساس Conditions مشخص کنترل میکند.Tripدر پاسخ به یک وضعیت حفاظتی، Action مشخصی را بهصورت خودکار اجرا میکند.برای مثال:High Temperature Alarmممکن است Operator را مطلع کند.اما:High-High Temperature Tripممکن است Heater را بهصورت خودکار خاموش کند.این دو از نظر فلسفه طراحی یکسان نیستند.همچنین هر High-Priority Alarm الزاماً نباید Trip ایجاد کند؛ Trip باید نتیجه تحلیل Process Safety، Equipment Protection و Control Philosophy باشد.
Alarm Management در فرآیندهای دارویی
در Pharmaceutical Systems، Alarm فقط برای حفاظت تجهیزات استفاده نمیشود.برخی Alarmها ممکن است مستقیماً با:
Product Quality
Batch Status
Cleaning Status
Sterilization Condition
Critical Process Parameter
در ارتباط باشند.برای مثال در یک SIP Cycle:
Temperature Below Validated Limit ممکن است در ابتدا یک Alarm ایجاد کند.اما اگر این Condition برای مدت مشخص ادامه پیدا کند، ممکن است اعتبار Sterilization Cycle نیز تحت تأثیر قرار گیرد.در نتیجه Alarm Logic باید در صورت نیاز با:Process State + Recipe Step + Batch Logicیکپارچه شود.Alarm در یک Pharmaceutical System نباید صرفاً بر اساس:
PV > Setpointطراحی شود.Context سیستم اهمیت دارد.
Alarm History و Data Integrity
در سیستمهای دارویی، برخی Alarm Records میتوانند بخشی از Electronic Records مرتبط با Process یا Batch باشند.در چنین سیستمهایی باید مشخص باشد:
چه Alarmی رخ داد؟
چه زمانی رخ داد؟
چه زمانی Acknowledge شد؟
چه Userی آن را Acknowledge کرد؟
چه تغییراتی در Configuration یا Record ایجاد شد؟
در صورت قرار گرفتن این Records در Scope سیستمهای مشمول الزامات GMP و Electronic Records، موضوعاتی مانند:
Timestamp
User Identification
Record Security
Audit Trail
Data Retention
و در صورت نیاز Electronic Signatureباید بر اساس Intended Use و Risk Assessment بررسی شوند.اما باید یک نکته مهم را روشن کرد:21 CFR Part 11 به این معنی نیست که هر Alarm یا هر Acknowledgement الزاماً باید Electronic Signature داشته باشد.Part 11 برای Electronic Records و Electronic Signatures مشمول مقررات کاربرد دارد و FDA نیز استفاده از Audit Trail و سایر Controls را بر اساس Predicate Rule و Risk توصیه میکند.
Alarm KPI؛ آیا Alarm System واقعاً خوب کار میکند؟
Alarm Management بدون Performance Monitoring ناقص است.
شاخصهایی مانند:
Alarm Rate
Standing Alarms
Chattering Alarms
Nuisance Alarms
Alarm Flood Events
Priority Distribution
Frequently Occurring Alarms
میتوانند تصویر واقعیتری از عملکرد Alarm System ارائه دهند.ممکن است یک سیستم در FAT کاملاً مناسب به نظر برسد، اما بعد از چند ماه Operation مشخص شود که:یک Instrument دائماً Alarm ایجاد میکند،یک Deadband نامناسب است،یا یک Sequence صدها Alarm غیرضروری ایجاد میکند.به همین دلیل Alarm Management یک فعالیت یکباره نیست؛ یک:Lifecycle Processاست.
ISA-18.2؛ مرجع اصلی Alarm Management
یکی از مهمترین مراجع صنعت برای Alarm Management:ANSI/ISA-18.2-2016 – Management of Alarm Systems for the Process Industriesاست.ISA این استاندارد را چارچوب اصلی مدیریت Alarm Systemها در Process Industries معرفی میکند و Alarm Management را در طول Lifecycle سیستم دنبال میکند.در کنار استاندارد اصلی، ISA مجموعهای از Technical Reportها نیز منتشر کرده است، از جمله:
ISA-TR18.2.1 – Alarm Philosophy
ISA-TR18.2.2 – Alarm Identification and Rationalization
ISA-TR18.2.3-2024 – Basic Alarm Design
ISA-TR18.2.5-2022 – Alarm System Monitoring, Assessment and Auditing
که موضوعات مختلف Lifecycle را با جزئیات بیشتری پوشش میدهند.
مفهوم اصلی این است که Alarm Management فقط Configuration چند Setpoint در PLC یا SCADA نیست.
Alarm Management Lifecycle
بهصورت مهندسی، مسیر Alarm Management را میتوان چنین دید:
Alarm Philosophy
↓
Identification
↓
Rationalization
↓
Detailed Design
↓
Implementation
↓
Operation & Maintenance
↓
Monitoring & Assessment
↓
Management of Change
↓
Continuous Improvement
ISA-18.2 Alarm Management را یک Lifecycle Discipline در نظر میگیرد، نه یک فعالیت محدود به Commissioning.
Alarm Philosophy؛ سندی که باید قبل از Configuration وجود داشته باشد
قبل از تعریف صدها Alarm در PLC، HMI یا SCADA، باید مشخص باشد سیستم Alarm بر اساس چه فلسفهای طراحی میشود.Alarm Philosophy میتواند موضوعاتی مانند موارد زیر را مشخص کند:
- تعریف Alarm، Event و Notification
- Priority Method
- Naming Convention
- Display Philosophy
- Colour Philosophy
- Deadband Rules
- Delay Rules
- Shelving Policy
- Suppression Strategy
- Acknowledgement Philosophy
- Alarm Logging
- Testing Requirements
- KPI و Performance Monitoring
- Management of Change
وجود این سند باعث میشود Automation Engineer، Process Engineer، Operator و QA یا Safety Team بر اساس یک منطق مشترک تصمیم بگیرند.
مثال مهندسی؛ Low Flow در یک CIP System
فرض کنیم Flow Rate در یک CIP System کاهش یافته است.یک طراحی ساده ممکن است بگوید:Flow < Setpoint → Low Flow Alarmاما طراحی Context-Based باید ابتدا شرایط Process را بررسی کند.مثلاً:
CIP Step = Circulation
AND
Pump = Running
AND
Flow < Minimum Validated Limit
AND
Condition persists for Defined Delay
THEN
Low Flow Alarm
حالا Alarm دقیقتر است.Operator با Alarmی مواجه میشود که در Context درست ایجاد شده است، نه صرفاً به دلیل اینکه Transmitter برای لحظهای عدد پایین نشان داده است.
سپس باید مشخص باشد:
Operator Action چیست؟
آیا Cycle باید Hold شود؟
آیا Cleaning Validation ممکن است تحت تأثیر قرار گیرد؟
آیا Batch/Event Review لازم است؟
این تفاوت یک Alarm معمولی با یک Context-Based Alarm است.
FAT؛ Alarm Testing فقط Alarm Bit نیست
یکی از اشتباهات رایج این است که در FAT فقط این سناریو تست شود:PV High → Alarm ONو:PV Normal → Alarm OFFاین تست فقط نشان میدهد Logic Bit عمل میکند.اما یک Alarm Test مناسب باید در صورت ارتباط بررسی کند:
- Setpoint صحیح است؟
- Priority صحیح است؟
- Deadband کار میکند؟
- Delay صحیح است؟
- Alarm در Process State درست فعال میشود؟
- Suppression Logic صحیح است؟
- Text و Tag صحیح هستند؟
- Operator Action تعریف شده؟
- Alarm History ثبت میشود؟
- Timestamp صحیح است؟
- Acknowledgement مطابق Design عمل میکند؟
- Return-to-Normal صحیح است؟
- Cascade غیرضروری ایجاد نمیشود؟
بنابراین:
Alarm Testing ≠ Alarm Bit Testingاین تفاوت در Commissioning سیستمهای پیچیده بسیار مهم است.
از Design تا Operation
یک مسیر مناسب برای طراحی و مدیریت Alarm System را میتوان اینگونه دید:
Process Understanding
↓
Alarm Philosophy
↓
Alarm Identification
↓
Rationalization
↓
Priority Assignment
↓
Detailed Configuration
↓
FAT / SAT
↓
Commissioning
↓
Operation
↓
Performance Monitoring
↓
Management of Change
↓
Continuous Improvement
این ساختار کمک میکند Alarm System همراه با فرآیند رشد و اصلاح شود.
جمعبندی
یک Alarm System خوب سیستمی نیست که بیشترین تعداد Alarm را تولید کند.سیستم خوب باید به Operator کمک کند:در زمان مناسب → Condition مهم را ببیند → Priority آن را بفهمد → Root Cause را بهتر تشخیص دهد → و Action مناسب را انجام دهد.در نتیجه کیفیت واقعی Alarm System حاصل تعامل مجموعهای از عوامل است:
Process Understanding + Alarm Philosophy + Rationalization + Priority + Context + Good HMI Design + Testing + Monitoring + Continuous Improvement
هدف Alarm Management این نیست که سیستم بیشتر هشدار بدهد.هدف این است که:وقتی واقعاً نیاز است، هشدار درست با Priority درست به فرد درست برسد.